- 洞察、案例与活动 - 柯尔柏
- 分析生物相似性
如何评估生物仿制药的分析生物相似性的合规性,并减少业务风险,加快产品上市?
阅读时长 9 分钟
生物仿制药(Biosimilars,也称生物类似药)已成为已获批生物药品可负担的替代药物,满足了业界对具有成本效益的治疗方案不断增长的需求。此类药物可提供有效、安全的治疗,同时减轻患者和医疗保健系统的经济负担。通过提供更多可负担得起的选择,生物仿制药有助于增加可及性并改善患者治疗效果。
比较分析评估的目的是验证在拟定的生物仿制药和参照药中观察到的各属性,具有相似的总体平均值和相似的总体标准差。
FDA
美国食品和药物管理局
因此,申请者应在监管申报提交文件中讨论这些方法的操作特征,并说明假阳性结论的风险低至可接受水平。
FDA
美国食品和药物管理局
应该采用哪种检测方法?
针对这些挑战,我们开发了一种创新的、新近发表的“自举法”检验方法,解决了等效检验和范围检验的局限性问题[5]。我们的检验方法是可取的:易于定义相似区域,同时检验生物仿制药与原研药之间的平均值和方差的差异,在整个相似条件下,将 I 类错误(假阳性率)控制在较低且可确定的水平(例如5%)[4]。
为什么要应用这项新的检验方法?
与现有范围检验方法(旨在控制 I 型错误)相比,我们新颖的自举法检验在相似区域的检验功效值(Power values)高达 10%。用非统计术语的方式来说:如果您是合格的生物仿制药,与控制 I 型错误的任何其他检验方法相比,您通过该检验的几率高 10%。另外,您也可以考虑通过节省比较所需的昂贵生产运营成本来实现相同的检验功效[5]。
这种优势使我们的检验方法符合现行监管要求,并将其定位为优于传统质量范围检验的替代方案。
该检验方法如何工作?
首先,让我们从最新的监管角度[4]了解一下,我们需要如何开展一项生物仿制药的相似性检验:
- 定义相似条件(Similarity condition):设定一个关于何时将两个数据分布视为“相似”的先验协议(priori agreement),即:针对每个CQA(关键质量属性)的两个数据总体分布之间的最大允差为多少。
- 定义相似标准(Similarity criteria):这可以被视为执行实际统计检验,以检查两个分布之间的真实差异是否不大于预先定义的相似条件。
相似条件
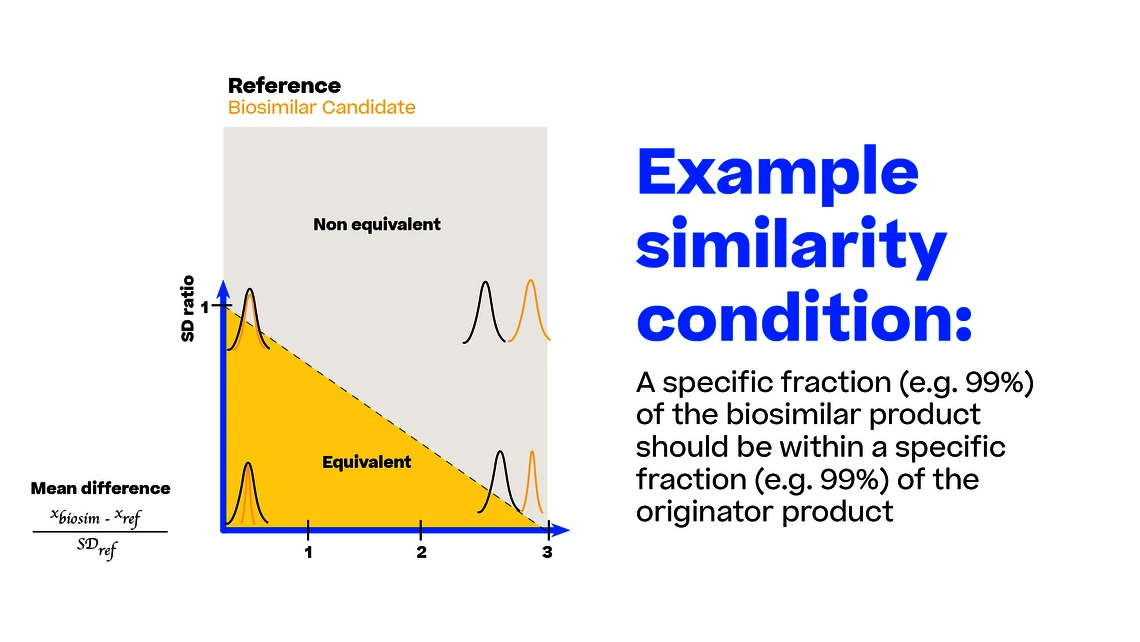
尽管针对两种分布之间的差异可以设定相似条件的任意先验协议,但让我们来看看图 1 [3]中所示的最主要条件之一。当候选生物仿制药生产的 99% 批次在原研药 99% 批次所涵盖的范围内时,我们在此定义其为“相似”。也允许有其他的说法,但必须符合关键质量属性(CQA)的临界值,例如 90% 的生物仿制药在 99% 的原研药的范围以内。这些相似条件在图1中转换为直线。
相似标准
在下面的内容展示了自举法检验这一新颖的统计学检验方法是如何工作的。您唯一需要事先了解的统计知识是如何计算样本的平均值和标准差。
如果您是数据科学领域的新人,可能还想了解一下自举法(Bootstrapping):自举法是一种统计再抽样的方法,它允许你去预估与“统计估计量”(Statistical estimator)相关的不确定性,或者根据一个样本的数据对总体做出推断。当您无法获得大量数据时,或者当基本分布未知或非参数化时,该方法尤其有用。自举法的基本理念是通过从原始数据集重复采样,替换创建多个“自举样本”(Bootstrap samples)。该流程涉及从原始样本中随机选择观察结果,允许多次或完全不选择同一观察结果。通过创建这些自举样本,您可以有效模拟从总体中抽取独立样本的过程。
还有哪些其他的检验方法?
3 SD 检验
3 SD检验将会验证您的生物仿制药的数据是否全部(或部分)在参比样本的数据±3 SD内。
最小-最大检验
可检查您的所有生物仿制药数据(或部分数据)是否在参比样品数据的最小-最大范围内。
等效检验
等效检验是针对等效接受标准 (Equivalence acceptance criteria)范围的下限和上限,分别进行双单侧 (TOST) 检验⁶。该检验方法仅验证总体平均值的差异。
平均值相似性检验 | 方差相似性检验 | 按 EMA 要求的控制 I 类错误* | |
|---|---|---|---|
最大-最小检验 | ✓ | ✓ | x |
3 SD 检验 | ✓ | ✓ | x |
TOST 等效检验 | ✓ | x | ✓ |
自举法检验 | ✓ | ✓ | ✓ |
表1:EMA最新的反思报告中提到的分析生物相似性*的不同常用检测方法的差异,要求了解 I 类错误(错误接受率)[4] 。FDA要求同研究平均值和方差的差异[2]。
为什么新颖的自举法比现在的其他检验方法更好?
要回答这个问题,我们应该明确一个合适的检验方法应该是怎么样的。
请见图2,当基础分布符合相似条件(100%接受率),则合适的检验方法会接受“生物相似性”,但当其不符合相似条件(0%接受率),则合适的检验方法不应该接受“生物相似性”。
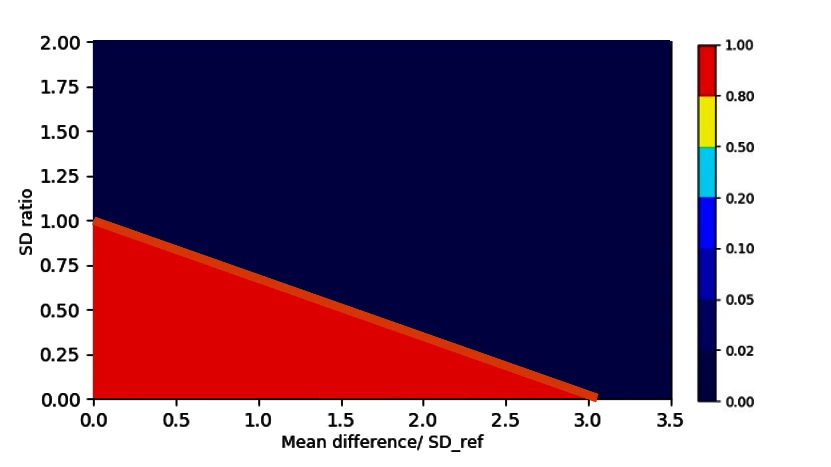
为了将不同检验方法的“不完善性 (imperfectness)”与该理想状态进行比较,我们可以从该坐标系的任何点生成具有给定样本量的样本数据(例如,生物仿制药和参照药各20批)。记住这个坐标系中的每一点,转换为生物仿制药和参照药总体的精确值(平均值和SD)。
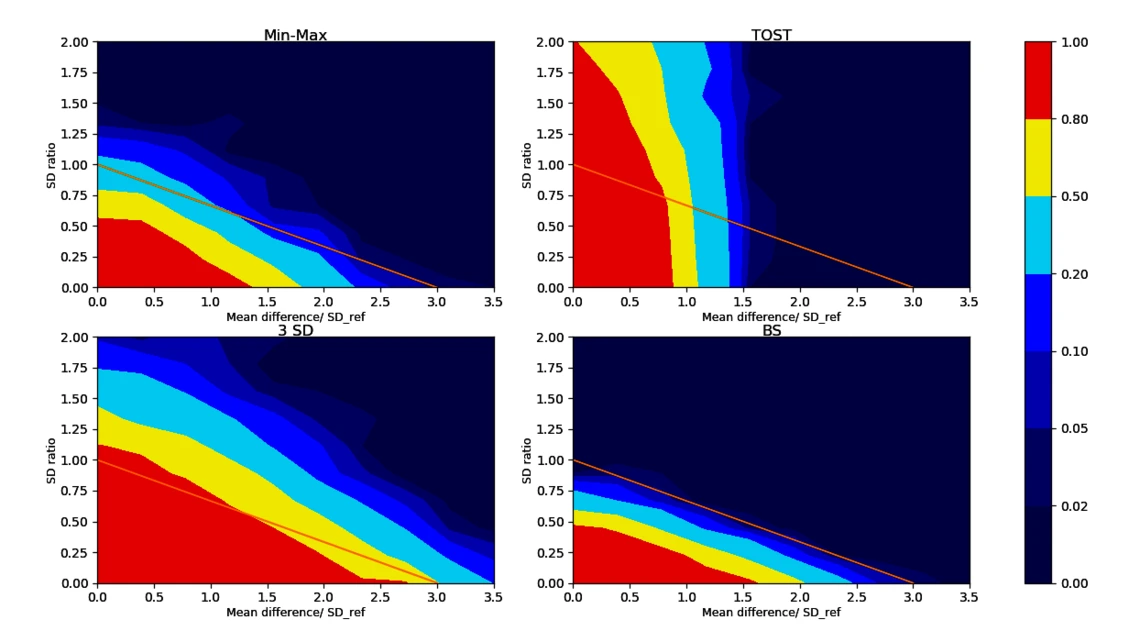
对于上面列出的每项检验方法,我们可以计算检验方法准确接受/拒绝生物相似性的频率。对于典型的样本量(例如,生物仿制药和参照药各20批),我们可参见图3中不同检验方法下在不同情形下的生物相似性的接受率图。
让我们将自举法检验与常用的3 SD检验进行比较:正如图3左下图所示,3 SD检验会接受在分布在大面积非等价区域的结果为“生物相似性”,可以由图片上相似条件之外的红色和黄色部分表示。这会导致监管风险较高,因为错误接受了那些不具有“生物相似性”的生物仿制药候选药物。此外,该检验方法存在缺陷,因为随着生物仿制药数据的样本量减小,其结果变得更容易通过[3, 4, 7]。同样的情况也适用于最小-最大检验方法(图3的左上方)。
如图3的右上图所示,当生物仿制药的总体的SD远大于参照药的SD(坐标系中的y值较大)时,TOST等效检验只能检验平均值(x轴)的差异,但不能正确地接受“生物相似性(红色区域)”。
如果想要更彻底的比较不同的检验方法,请参阅同行评审出版物[5]。
结论
通过采用我们的自举法检验,您可以自信地确定生物仿制药的分析相似性,从而避免昂贵的临床试验。
- 它提供了一种稳健而全面的方法,满足了监管机构的要求,并有助于确保药物获批流程的成功。
- 与控制 I 型错误的其他检验方法相比,它甚至使您被接受为生物仿制药的几率增加了10%,或者节省检验次数。因此,该检验方法大大降低了您的业务风险、节约了所需资源和上市时间。
请随时联系我们!
参考资料
作者信息
Thomas Zahel
CMC 创新咨询部门的负责人
Thomas Zahel 是柯尔柏 CMC 创新咨询部门的负责人。他拥有格拉茨技术大学生物化学工程硕士学位和维也纳技术大学应用统计学博士学位。他在众多统计学科的理论和具体的操作实施方面拥有夯实的专业知识,并在开发工艺表征统计工作流程领域拥有丰富的经验。
您可能还对以下内容感兴趣: